Categoría: Artículos y análisis

Artículos y análisis

  • Auditoría del diseño conjunto de iluminación perimetral y cámaras

    Auditoría del diseño conjunto de iluminación perimetral y cámaras

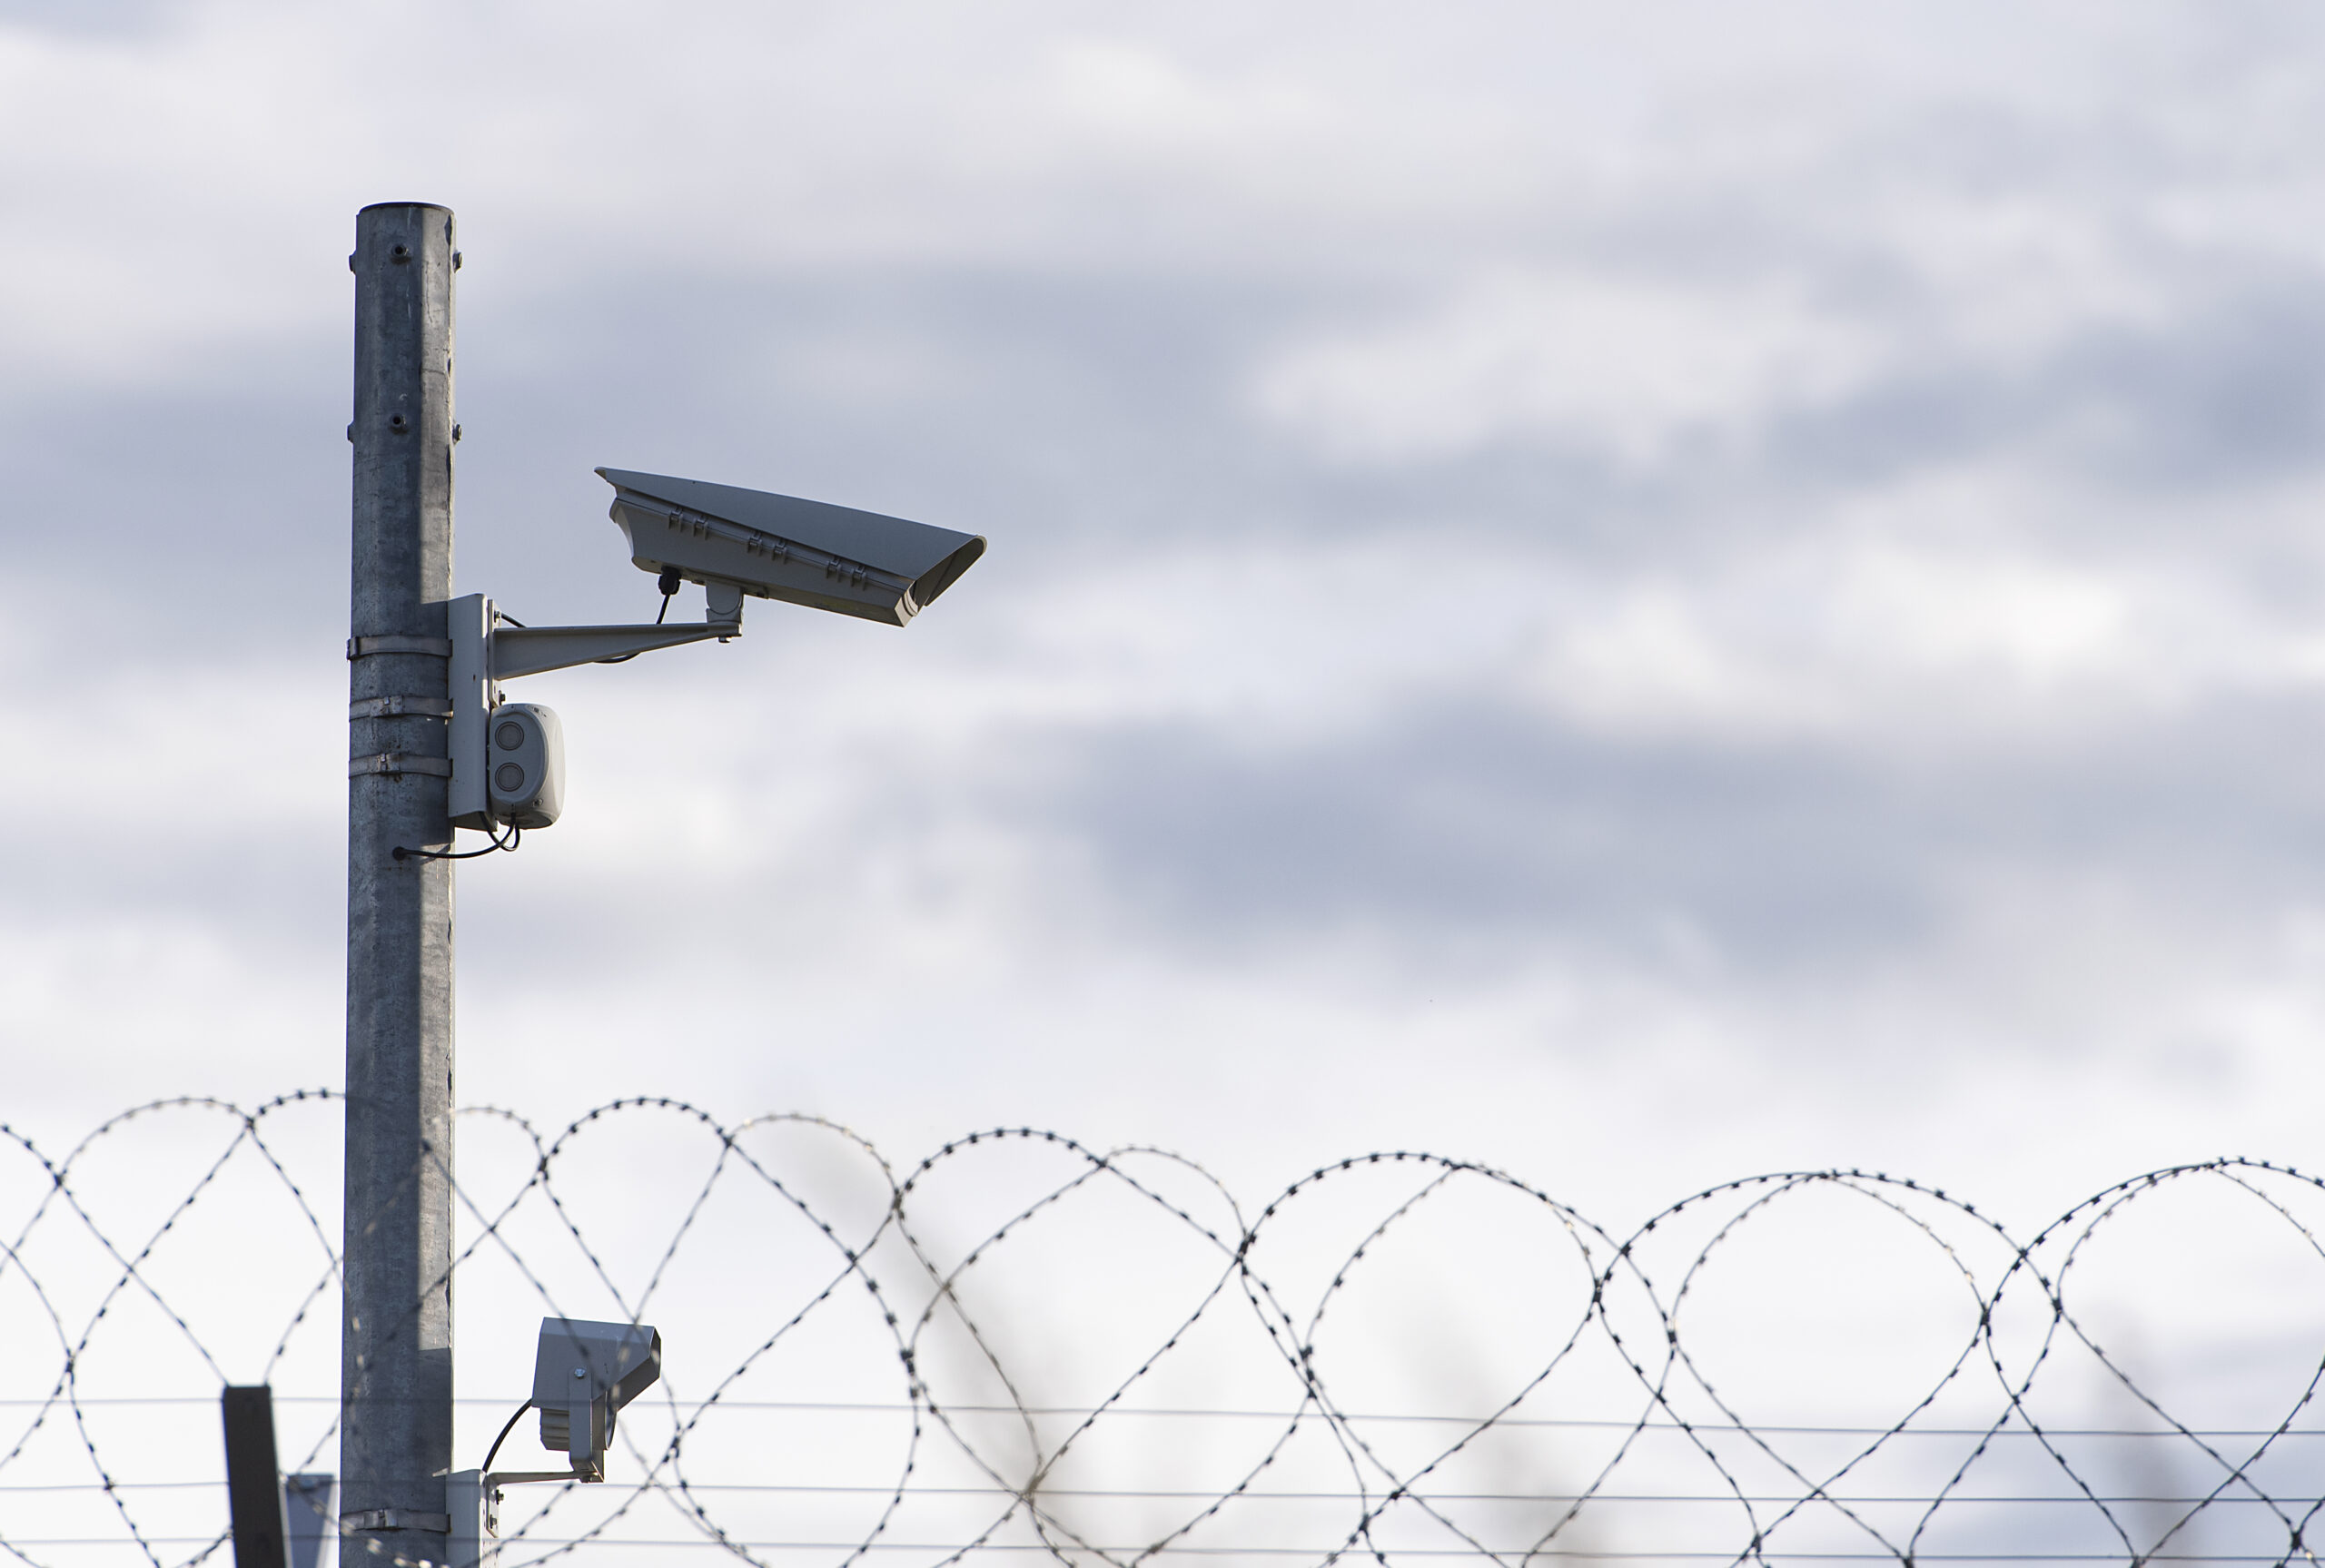
    La iluminación perimetral y la videovigilancia suelen ser diseñadas por equipos diferentes, aunque su rendimiento está estrechamente relacionado. Una mayor cantidad de luz no produce automáticamente mejores evidencias. Una orientación deficiente puede generar deslumbramiento, sombras profundas, reflejos y cambios rápidos de exposición que reducen el reconocimiento y desestabilizan la analítica. Una auditoría del diseño conjunto evalúa la cámara, la luminaria y la escena como un único sistema de detección.

    Definir la tarea operativa

    Para cada cámara, indique si el objetivo es la detección, la observación, el reconocimiento o la identificación. Registre el área objetivo, el movimiento esperado, la retención requerida y la respuesta del operador. Los criterios de iluminación deben ajustarse a esa tarea y no a un valor genérico de luminosidad para todo el emplazamiento.

    Documente la posición de la cámara, el objetivo, el campo de visión, la altura de montaje, el modo día/noche, la capacidad infrarroja y las zonas de analítica. Para la iluminación, registre el tipo de luminaria, el patrón del haz, las características cromáticas, los controles, la fuente de alimentación y el estado de mantenimiento.

    Medir la escena al anochecer

    Inspeccione el perímetro en condiciones nocturnas representativas. Evalúe la iluminación horizontal y vertical, la uniformidad, el contraste y la transición entre zonas claras y oscuras. Los objetivos de las cámaras son tridimensionales, por lo que un plano del suelo bien iluminado puede dejar aún en sombra los rostros o las marcas de los vehículos.

    Observe el deslumbramiento directo hacia el objetivo, los reflejos en vallados o superficies mojadas y la contraluz procedente de carreteras o propiedades adyacentes. Realice las pruebas con la vegetación, las puertas y los vehículos estacionados en sus posiciones reales. Las directrices de seguridad física de la CISA destacan la evaluación por capas en lugar de la dependencia de un único control.

    Probar la respuesta de la cámara y la analítica

    Revise el vídeo en directo y grabado mientras un objetivo representativo se desplaza por la escena. Compruebe el comportamiento del obturador, el desenfoque de movimiento, el ruido, el balance de blancos, la conmutación a infrarrojos y la compresión. Confirme que los cambios de iluminación no sobreexpongan los objetivos cercanos ni oculten los distantes.

    Ejecute pruebas de aceptación de la analítica en toda la zona y en las condiciones límite. Los faros, los insectos, la lluvia y las sombras móviles pueden generar alarmas molestas. La guía de SectechMedia sobre nueva puesta en servicio de la analítica de vídeo ofrece un método estructurado para validar las zonas después de cambios en la escena.

    Coordinar la resiliencia y los controles

    Determine qué ocurre durante un fallo de la red eléctrica, una transferencia al generador y la pérdida de la red de control de iluminación. Las cámaras críticas pueden requerir iluminación de emergencia o cobertura infrarroja independiente. Evite un único comando de control que pueda desactivar tanto la iluminación como la vigilancia sin generar una alarma.

    El acceso a los controles de iluminación debe estar restringido y registrarse. Los horarios, las fotocélulas y los comandos de gestión central necesitan relojes coherentes y anulaciones documentadas.

    Documentar las acciones correctivas y los cambios estacionales

    Utilice imágenes anotadas para registrar deslumbramientos, sombras, zonas muertas y cambios recomendados de orientación o de equipos. Repita las pruebas después del crecimiento de la vegetación, obras, modificaciones del vallado o sustitución de luminarias. Limpie los objetivos y las luminarias, verifique los soportes y analice las tendencias de las lámparas averiadas. Una auditoría satisfactoria demuestra que el sistema combinado proporciona evidencias utilizables y una detección estable en condiciones nocturnas reales.

    Fuentes

  • Pruebas de rutas de escalamiento de alarmas en operaciones de seguridad

    Pruebas de rutas de escalamiento de alarmas en operaciones de seguridad

    Una alarma no es operativamente eficaz por el mero hecho de aparecer en una pantalla. El evento debe llegar al operador correcto, incluir contexto suficiente para tomar una decisión y escalar cuando se retrasa la confirmación o la respuesta. Las pruebas de las rutas de escalamiento validan la cadena humana y técnica desde la activación del sensor hasta la resolución documentada.

    Cartografiar la ruta de respuesta completa

    Documente las fuentes de eventos, el middleware, las consolas de supervisión, las notificaciones móviles, los árboles de llamadas y los servicios externos. Para cada clase de alarma, identifique la prioridad, el propietario, el objetivo de confirmación, el intervalo de escalamiento y la respuesta requerida. Incluya el horario fuera de jornada, los fines de semana, la cobertura de contratistas y los periodos en los que la sala de control principal no esté disponible.

    Separe la recepción técnica de la responsabilidad operativa. Una pasarela puede entregar correctamente un evento mientras la cola de destino carece de personal o el mensaje no incluye el contexto del sitio y del dispositivo.

    Crear escenarios de prueba representativos

    Utilice eventos de prueba aprobados para intrusión, denegación de acceso, puerta forzada, analítica de vídeo, avería de la interfaz del sistema contra incendios y pérdida de comunicaciones, según corresponda. Incluya eventos duplicados, alarmas simultáneas y una alarma dejada deliberadamente sin confirmar. Defina las marcas de tiempo y los destinatarios esperados antes de la prueba.

    Evite depender únicamente de señales de mantenimiento de baja prioridad. Los flujos de alta prioridad suelen utilizar canales, aprobaciones y contactos externos diferentes, por lo que necesitan sus propios ejercicios controlados.

    Medir el contexto y los tiempos

    Registre la hora de detección, la recepción en la plataforma, la presentación al operador, la confirmación, el escalamiento y el cierre. Verifique que el mensaje incluya el sitio, la zona, el dispositivo, la prioridad y la instrucción de respuesta correctos. Los enlaces a vistas de cámaras o procedimientos deben abrirse para el rol receptor sin requerir un intercambio inseguro de credenciales.

    La coherencia de los relojes es esencial cuando los eventos atraviesan varios sistemas. La guía de SectechMedia sobre pruebas de marcas de tiempo y sincronización de relojes explica cómo establecer una secuencia fiable.

    Ejercitar condiciones de fallo y relevo

    Pruebe una confirmación omitida, un supervisor no disponible, un canal de notificación fallido y un cambio de turno. La alarma debe pasar a la siguiente ruta aprobada sin perder prioridad ni duplicar respuestas no controladas. Confirme que las ubicaciones de supervisión de respaldo reciban el estado actual y no solo los eventos nuevos.

    Los equipos de respuesta externos deben participar mediante canales de ejercicio acordados. Valide los datos de contacto y las frases de autenticación sin generar un despacho de emergencia no intencionado.

    Cerrar con un registro auditable

    Compare los tiempos y las acciones observados con los niveles de servicio. Clasifique los fallos como problemas de configuración, comunicación, dotación de personal, procedimiento o formación, y asigne acciones correctivas. Vuelva a probar las rutas fallidas y actualice inmediatamente los árboles de llamadas. Las directrices de respuesta a incidentes del NIST destacan la preparación, la claridad de roles y la mejora continua; las pruebas de escalamiento de alarmas aplican esos principios a las operaciones físicas y ciberfísicas.

    Conserve la matriz de contactos probada con control de versiones y un propietario responsable.

    Probar la gobernanza y la gestión de excepciones

    Incluya una alarma que llegue con contexto incompleto, un destinatario que no pueda responder y una supresión temporal por mantenimiento. Verifique que las excepciones tengan una duración limitada, estén aprobadas y sean visibles para el siguiente turno. Las alarmas molestas repetidas deben escalarse para su corrección técnica en lugar de normalizarse. Registre cada solución manual, porque los pasos informales suelen ser la primera parte de la cadena que falla durante un incidente real.

    Fuentes de referencia

  • Pruebas de tolerancia a fallos y recuperación de redes de alarma contra incendios

    Pruebas de tolerancia a fallos y recuperación de redes de alarma contra incendios

    Los sistemas de alarma contra incendios en red distribuyen la detección, el control y la señalización entre paneles, nodos y rutas de comunicación. Un estado normal no demuestra que una rotura de cable, el fallo de un nodo o una pérdida de alimentación se aislarán correctamente. Las pruebas de tolerancia a fallos verifican que el diseño notifique rápidamente la avería, conserve las funciones de alarma requeridas y vuelva al servicio sin fallos ocultos.

    Cartografiar la red y la supervivencia requerida

    Comience con planos actuales que muestren paneles, bucles, interfaces de red, anunciadores, fuentes de alimentación y medios de comunicación. Identifique las rutas redundantes, los aisladores y las dependencias de conmutadores o conversores de fibra compartidos. El diseño aprobado y la documentación de los equipos deben definir qué funciones deben permanecer disponibles ante cada fallo.

    Registre el estado normal de los nodos, las versiones de software, la sincronización y el enrutamiento de eventos. Una prueba no puede demostrar la recuperación si la línea base ya contiene averías intermitentes o anulaciones no documentadas.

    Crear una matriz de fallos controlados

    Planifique un fallo cada vez: circuito abierto, cortocircuito cuando sea seguro, pérdida de un segmento de red, pérdida de un nodo, interrupción de la alimentación principal y fallo de una ruta redundante. Defina la indicación esperada del panel, el área afectada, la ruta de notificación y el comportamiento de restauración antes de introducir la condición.

    Coordine las indisponibilidades con el personal responsable y los procedimientos de emergencia. Utilice métodos de prueba aprobados y nunca anule la protección de seguridad humana sin una medida compensatoria autorizada. El propósito es verificar el comportamiento del diseño, no improvisar pruebas destructivas.

    Observar la separación entre alarma y avería

    Confirme que un fallo de comunicación genera la condición de avería correcta e identifica el segmento afectado. A continuación, introduzca una entrada de alarma permitida en una parte no afectada de la red. La alarma debe conservar la prioridad, ubicación y acciones de causa y efecto previstas, en lugar de quedar enmascarada por la avería existente.

    Compruebe el funcionamiento del panel local, la señalización remota, la transmisión a la central receptora y el registro de eventos. La descripción general de SectechMedia sobre paneles de control de alarma contra incendios explica cómo los eventos de los dispositivos de campo dependen de la arquitectura de control general.

    Probar la redundancia y los modos degradados

    Cuando se proporcione un anillo, una ruta doble o un servidor redundante, mida el comportamiento de la transferencia e identifique cualquier pérdida temporal de visibilidad. Verifique que los aisladores limiten el fallo a la sección prevista. Para los componentes conectados por IP, confirme que la conmutación por error de la red no introduzca estados obsoletos, eventos duplicados ni desviación del reloj.

    Pruebe el funcionamiento con respaldo de batería y la restauración en la secuencia exigida por el fabricante. Un nodo que vuelve a conectarse debe sincronizar la configuración y el estado sin generar falsas alarmas ni borrar silenciosamente una avería no resuelta.

    Cerrar cada indisponibilidad con evidencias

    Registre el fallo inyectado, las marcas de tiempo, los mensajes mostrados, las funciones supervivientes, la secuencia de restauración y la acción correctiva. Devuelva todos los paneles y sistemas de supervisión al estado normal y, a continuación, verifique que no quede ningún punto deshabilitado ni ninguna anulación. Repita las pruebas después de cambios de topología, sustituciones de paneles o actualizaciones importantes de software. Los recursos de investigación de incendios del NIST refuerzan la importancia de las evidencias empíricas de rendimiento en la ingeniería de seguridad contra incendios.

    Revisar las tendencias después de la restauración

    Una vez restablecido el servicio normal, revise el historial de averías para detectar oscilaciones repetidas de enlaces, reinicios de nodos o sincronizaciones retrasadas. Los patrones intermitentes pueden revelar cableado deficiente, alimentación inestable o interfaces sobrecargadas que una única prueba de aprobado o suspenso no detecta. Asigne un seguimiento y confirme que los registros de mantenimiento identifiquen la topología exacta y el estado del firmware sometidos a prueba.

    Fuentes de referencia

  • Pruebas de persistencia de máscaras de privacidad y desviación de configuración en cámaras

    Pruebas de persistencia de máscaras de privacidad y desviación de configuración en cámaras

    Las máscaras de privacidad están destinadas a impedir que los operadores, las grabaciones y los análisis posteriores visualicen áreas protegidas. Una máscara que parece correcta durante la puesta en servicio puede desviarse después de un ajuste del objetivo, un cambio en la estabilización electrónica, la sustitución de la cámara, una actualización de firmware o la modificación de un preajuste. Las pruebas de persistencia demuestran que la protección permanece alineada en todos los modos operativos reales de la cámara.

    Definir la escena protegida y la política

    Documente el motivo de cada máscara, la geometría protegida y las vistas en las que debe aplicarse. Registre el modelo de cámara, el firmware, la posición del objetivo, la resolución, la orientación y los ajustes de corrección de imagen. Utilice referencias fijas de la escena, como bordes de paredes, ventanas o marcadores estructurales, en lugar de muebles o vehículos móviles.

    Las capturas de pantalla por sí solas son insuficientes porque no describen lo que ocurre durante el zoom, la transición día/noche o el reinicio. Identifique al propietario aprobado y el proceso de cambio de cada máscara.

    Probar cada ruta de vídeo relevante

    Verifique la máscara en la visualización en directo, la reproducción grabada, los flujos secundarios, los clientes móviles, los decodificadores de videowall y los clips exportados. Confirme que las instantáneas, las miniaturas y las vistas previas de analítica no revelen la región protegida. Si la cámara genera metadatos fuera de la imagen enmascarada, determine si las coordenadas o clasificaciones siguen exponiendo actividad sensible.

    Pruebe cada resolución y relación de aspecto compatibles. Una máscara definida en un sistema de coordenadas puede desplazarse cuando un flujo se recorta o gira. La guía de SectechMedia sobre nueva puesta en servicio de la geometría de zonas de analítica de vídeo ofrece un método relacionado para comprobar la geometría de la escena.

    Ejercitar el movimiento y los modos operativos

    Para cámaras PTZ, pruebe cada preajuste, patrulla y límite manual. Confirme si las máscaras están vinculadas a coordenadas absolutas de giro, inclinación y zoom, y si permanecen estables durante el movimiento. Para cámaras fijas, pruebe el zoom óptico, la estabilización electrónica, la corrección de distorsión, el modo pasillo y la conmutación día/noche.

    Observe las transiciones, no solo las posiciones finales. Una ventana protegida no debe quedar visible brevemente mientras se desplaza un preajuste o cambia la exposición.

    Introducir cambios controlados de configuración

    Reinicie la cámara y el grabador, restaure una copia de seguridad de la configuración en un dispositivo representativo y aplique una actualización de firmware compatible. Verifique el número, la forma, la posición y la aplicación de las máscaras después de cada acción. Compare la configuración actual con una línea base aprobada para poder detectar desviaciones antes de la inspección visual.

    Restrinja la edición de máscaras a roles autorizados y confirme que los cambios generen un evento de auditoría. Las exportaciones de gestión que contengan coordenadas de máscaras deben recibir la misma protección que otros datos de configuración sensibles.

    Documentar las evidencias y los desencadenantes de nuevas pruebas

    Conserve imágenes de referencia anotadas de cada flujo y modo, hashes de configuración cuando sean compatibles, la identidad del operador y las marcas de tiempo de las pruebas. Clasifique los fallos como problemas de geometría, cliente, grabación, analítica o control de cambios. Repita las pruebas después de mover la cámara, intervenir el objetivo, cambiar el firmware, modificar la escena o revisar la política de privacidad. Los marcos de seguridad y privacidad del NIST proporcionan una base de gobernanza para mantener estas evidencias.

    Verificar el comportamiento del operador y del grabador

    Confirme que los roles no autorizados no puedan desactivar ni redimensionar las máscaras y que las superposiciones del lado del grabador no sustituyan la aplicación por parte de la cámara. Revise los registros de auditoría de cada cambio aprobado y compare después las vistas en directo, grabadas y exportadas una vez guardada la configuración.

    Fuentes de referencia

  • Validación de copias de seguridad y restauración de controladores de acceso

    Validación de copias de seguridad y restauración de controladores de acceso

    Las plataformas de control de acceso suelen informar de que una copia de seguridad se ha completado correctamente, pero ese mensaje no demuestra que un controlador pueda restaurarse tras un fallo de hardware, una corrupción o una actualización fallida. Un programa de recuperación útil valida todo el estado operativo: identidades, credenciales, configuración de puertas, horarios, lógica de alarmas, integraciones, material criptográfico y evidencias de auditoría.

    Definir la configuración recuperable

    Comience con un inventario de controladores, módulos de expansión, lectores, interfaces y versiones de software. Registre qué información reside de forma centralizada y cuál permanece únicamente en el hardware de campo. Algunos sistemas realizan copias de seguridad de la base de datos del servidor, pero omiten archivos específicos del controlador, certificados, scripts personalizados o secretos de integración. Documente los componentes exactos necesarios para reconstruir cada clase de controlador.

    Establezca objetivos de recuperación que reflejen el riesgo operativo. La entrada de una sede central y un armario remoto de servicios públicos pueden requerir distintos tiempos de recuperación y tolerancias de pérdida de datos. Las directrices de planificación de contingencias del NIST recomiendan vincular los procedimientos técnicos de recuperación con el impacto empresarial en lugar de depender de un único calendario genérico de copias de seguridad.

    Proteger las copias de seguridad como activos de seguridad

    Las copias de seguridad de controladores pueden contener datos de titulares de credenciales, direcciones de red, claves de cifrado y configuración privilegiada. Almacénelas con cifrado, acceso basado en roles, comprobaciones de integridad y controles de retención. Mantenga al menos una copia fuera del entorno de gestión de producción para que el ransomware o un error administrativo no puedan eliminar tanto el sistema activo como su material de recuperación.

    Cada copia de seguridad debe tener un dispositivo de origen identificable, una versión de software, una hora de creación y un propietario aprobado. Los hashes y el almacenamiento inmutable pueden ayudar a detectar cambios no intencionados. Las credenciales de restauración deben controlarse por separado de las cuentas rutinarias de los operadores.

    Restaurar en un entorno de prueba representativo

    Utilice hardware de repuesto o aislado que coincida con un controlador de producción. Restaure la copia de seguridad y verifique que el dispositivo arranca, establece comunicaciones seguras y recibe la configuración prevista. Compare los recuentos de titulares de tarjetas, niveles de acceso, horarios, festivos, parámetros de puertas, lógica de entrada/salida y enrutamiento de eventos con la línea base.

    No basta con que una base de datos se abra sin errores. Pruebe una credencial válida, una credencial denegada, una alarma de puerta forzada, una interrupción de las comunicaciones y una decisión local mientras el dispositivo está desconectado del servidor. La guía de SectechMedia sobre pruebas de eventos y reloj del control de acceso ofrece comprobaciones complementarias para la fiabilidad de la auditoría.

    Tener en cuenta las dependencias de versiones y claves

    La recuperación puede fallar cuando el hardware de sustitución ejecuta una rama de firmware diferente o cuando los certificados y las claves de cifrado no están disponibles. Pruebe las rutas compatibles de actualización y reversión, los procedimientos de importación de claves y la restauración de licencias. Si una copia de seguridad solo puede restaurarse mediante una versión intermedia del software, conserve ese instalador y documente la secuencia.

    Las integraciones con sistemas de identidad, plataformas de vídeo y gestión de visitantes deben probarse con terminales que no sean de producción. Confirme que los conectores restaurados no envíen comandos accidentalmente ni dupliquen registros en los sistemas activos.

    Cerrar la prueba con evidencias

    Registre la duración de la recuperación, el alcance de los datos restaurados, las excepciones y las acciones correctivas. Actualice el procedimiento operativo después de cada cambio de arquitectura o firmware y repita las pruebas según un calendario basado en el riesgo. Un programa maduro de copias de seguridad demuestra la capacidad de recuperación mediante resultados observados, no solo mediante la existencia de archivos.

    Fuentes de referencia

  • Supervisión del bucle antisabotaje de sensores perimetrales y pruebas de inyección de fallos

    Supervisión del bucle antisabotaje de sensores perimetrales y pruebas de inyección de fallos

    Un sensor perimetral puede detectar correctamente una intrusión mientras su ruta de supervisión falla de forma silenciosa. Los circuitos abiertos, cortocircuitos, sabotajes de carcasas, resistencias de derivación y pérdidas de comunicación deben producir condiciones distintas sobre las que se pueda actuar. Las pruebas de inyección de fallos verifican que la cadena completa —desde el sensor de campo hasta la interfaz del operador— reconoce esos fallos sin confundirlos con alarmas de intrusión reales.

    Cartografiar cada ruta supervisada

    Documente las zonas de sensores, cajas de conexiones, puntos de terminación, interruptores antisabotaje, componentes de fin de línea, supervisión de alimentación y enlaces de comunicaciones. Identifique qué fallos se detectan localmente y cuáles dependen del controlador o de la plataforma de gestión. Registre los valores eléctricos normales y la configuración antes de las pruebas.

    Las distintas arquitecturas realizan la supervisión de formas diferentes. Un bucle equilibrado, un dispositivo direccionable y un procesador de detección por fibra conectado a la red no pueden compartir un único procedimiento de prueba genérico. Utilice la documentación del fabricante y el diseño aprobado para definir las respuestas esperadas.

    Crear una matriz segura de fallos

    El plan de pruebas debe abarcar la apertura de la carcasa, la apertura del circuito del cable, el cortocircuito del cable, la pérdida de alimentación, la interrupción de las comunicaciones y la retirada o sustitución de componentes de supervisión cuando sea seguro y esté permitido. Incluya fallos cerca del controlador y en puntos de campo remotos para que el equipo pueda detectar debilidades ocultas por la topología del cableado.

    Defina el estado esperado para cada inyección: sabotaje, avería, fallo de comunicación u otra condición supervisada. Defina también lo que no debe ocurrir. Un fallo de mantenimiento no debe borrar una alarma de intrusión simultánea ni hacer que las zonas adyacentes dejen de estar disponibles sin previo aviso.

    Verificar la experiencia del operador

    Observe el texto del mensaje, la identidad de la zona, la prioridad, la indicación audible, el registro de eventos, el escalado y la restauración. Las etiquetas ambiguas como «error del dispositivo» ralentizan la respuesta y pueden ocultar problemas recurrentes de campo. Confirme que el reconocimiento no elimina la condición subyacente y que la restauración solo se registra después de corregir físicamente el fallo.

    Pruebe las rutas de notificación a clientes móviles, centros de mando y sistemas de mantenimiento cuando formen parte del concepto operativo. La guía de SectechMedia sobre segmentación de zonas perimetrales y pruebas de transferencia ofrece un método complementario para validar los límites de cobertura.

    Comprobar la resiliencia frente a intentos sencillos de elusión

    Cuando esté autorizado, compruebe si una sustitución de resistencia predecible, un interruptor puenteado o un sensor desconectado pueden imitar el estado normal. El propósito es la verificación defensiva, no proporcionar instrucciones de elusión: los procedimientos deben estar controlados, supervisados y limitados a personal autorizado. Los hallazgos pueden justificar la supervisión multiestado, las carcasas protegidas, las comunicaciones cifradas o un mejor tendido del cableado.

    Las directrices de NIST sobre tecnología operativa hacen hincapié en la integridad, la disponibilidad y las rutas de comunicación supervisadas. Esos principios se aplican directamente a los sistemas perimetrales que deben seguir siendo fiables pese a daños ambientales, errores de mantenimiento o interferencias deliberadas.

    Cerrar los fallos con pruebas

    Para cada prueba, conserve la condición inyectada, la respuesta observada, la marca de tiempo del evento, el comportamiento de restauración y la medida correctiva. Vuelva a realizar pruebas después de cambios de firmware del controlador, reparaciones de cables, ampliaciones de zonas o trabajos de integración. Analice las tendencias de eventos molestos de avería y restauraciones intermitentes; a menudo revelan conexiones degradadas antes de un fallo completo. Un programa de supervisión maduro demuestra no solo que el sensor detecta un objetivo, sino también que el sistema informa cuando ya no se puede confiar en el sensor.

    Fuentes de referencia

  • Auditoría del campo de visión y las obstrucciones de detectores de llama

    Auditoría del campo de visión y las obstrucciones de detectores de llama

    Los detectores ópticos de llama dependen de una relación despejada entre el peligro y el sensor. Un detector puede permanecer alimentado, supervisado y libre de señales de avería mientras su campo de visión efectivo se ha reducido por equipos nuevos, almacenamiento temporal, tuberías, suciedad o una disposición modificada del proceso. Una auditoría del campo de visión comprueba si la geometría de detección instalada sigue correspondiéndose con el peligro actual.

    Reconstruir el objetivo de detección

    Identifique los combustibles, las ubicaciones probables de las llamas, los escenarios de liberación, la respuesta requerida y las limitaciones ambientales que sustentaron el diseño original. Revise la tecnología del detector, el ángulo de visión homologado, el ajuste de sensibilidad, la altura de montaje y la orientación utilizando la documentación actual del fabricante. No sustituya los datos de cobertura específicos del modelo por un cono genérico en un plano.

    Defina el volumen de peligro protegido en lugar de limitarse a comprobar si el detector apunta hacia la sala. Los derrames, las liberaciones por pulverización, los equipos elevados y las áreas de proceso protegidas pueden requerir líneas de visión diferentes.

    Inspeccionar los cambios físicos y del proceso

    Recorra la vista de cada detector tanto desde la perspectiva del sensor como desde la del peligro. Registre obstrucciones fijas, equipos móviles, bandejas de cables, estructuras de acero, componentes de ventilación y barreras transparentes. Examine si las plataformas de mantenimiento, los materiales almacenados o los equipos estacionales pueden entrar en la línea de visión después de la auditoría.

    Los cambios del proceso importan tanto como la construcción. Un recipiente, quemador o punto de transferencia puede haberse desplazado mientras el detector permanecía en su posición original. Actualice los planos y las fotografías para que la próxima inspección pueda distinguir la deriva gradual de un cambio de diseño aprobado.

    Comprobar las interferencias ambientales

    Inspeccione lentes, ventanas y carcasas protectoras en busca de contaminación, condensación, daños en el revestimiento o residuos de limpieza. Revise las fuentes de radiación e interferencia relevantes para la tecnología del detector, incluidos equipos calientes, soldadura, luz solar directa y reflejos. La mitigación ambiental debe seguir las instrucciones del fabricante y el diseño de protección contra incendios aprobado.

    NFPA 72 establece requisitos para los sistemas de alarma y señalización de incendios, pero la aceptación y el mantenimiento siguen dependiendo de las instrucciones de los equipos homologados y de la ingeniería específica del emplazamiento. Por tanto, la auditoría debe vincular las obligaciones normativas con el modelo de detector y el peligro reales.

    Utilizar pruebas funcionales controladas

    Cuando esté permitido, utilice una fuente de prueba aprobada y siga los requisitos de distancia, alineación y seguridad del fabricante. Confirme la recepción de la alarma, la identidad correcta del dispositivo, las acciones de causa y efecto y el comportamiento de restablecimiento. Una prueba que activa el detector desde una posición sencilla no demuestra la cobertura del peligro previsto; los puntos de prueba deben representar la geometría del riesgo.

    Coordine las pruebas con las operaciones y los procedimientos de indisponibilidad antes de realizarlas. La descripción general de SectechMedia sobre paneles de control de alarmas contra incendios explica cómo los eventos de dispositivos de campo entran en la cadena más amplia de alarma y respuesta.

    Documentar las deficiencias y las medidas correctivas

    Clasifique los hallazgos como problemas de obstrucción, orientación, contaminación, cambio del peligro, configuración o documentación. Asigne responsables y fechas de finalización y, a continuación, vuelva a probar las posiciones corregidas. Conserve fotografías anotadas, ajustes de los detectores y pruebas. El objetivo es demostrar una cobertura continua, no limitarse a mostrar que un detector generó una alarma durante una visita anual.

    Fuentes de referencia

  • Verificación de la segmentación de red en sistemas de seguridad física

    Verificación de la segmentación de red en sistemas de seguridad física

    Los diagramas de red suelen mostrar los sistemas de seguridad física en zonas cuidadosamente separadas, pero un diagrama no demuestra que los controles funcionen. La deriva de los cortafuegos, las reglas temporales de mantenimiento, los servidores conectados a dos redes y los conmutadores no gestionados pueden volver a conectar redes que debían permanecer aisladas. La verificación de la segmentación prueba las rutas desplegadas en lugar de confiar en el documento de diseño.

    Definir zonas y flujos permitidos

    Comience por zonas funcionales como dispositivos de campo, controladores, grabación, gestión, clientes de operador, servicios de integración y soporte remoto. Para cada par de zonas, documente el origen, destino, protocolo y propósito empresarial exactos permitidos. Todo lo demás debe denegarse de forma predeterminada cuando la arquitectura lo permita.

    Incluya dependencias que es fácil pasar por alto: DNS, NTP, inscripción de certificados, servicios de directorio, repositorios de software, retransmisores de correo electrónico y supervisión. Una lista de permitidos incompleta puede empujar a los equipos a implantar reglas de emergencia amplias que después se vuelven permanentes.

    Verificar desde puntos finales representativos

    Las pruebas deben originarse en clases reales de dispositivos o equivalentes seguros. Un análisis desde la red de TI no puede demostrar a qué puede acceder una cámara o un controlador integrado. Confirme las conexiones previstas y después intente recorrer rutas prohibidas de forma controlada. Revise tanto el resultado del cliente como el registro del cortafuegos o conmutador para poder distinguir entre descartes silenciosos y fallos de enrutamiento.

    Las directrices de NIST sobre seguridad de tecnología operativa recomiendan la segmentación y las rutas de comunicación controladas como medidas centrales de reducción de riesgos. Las redes de seguridad física comparten muchas de las mismas limitaciones: dispositivos de larga vida útil, protocolos de proveedores, requisitos de disponibilidad y protección limitada de los puntos finales.

    Probar por separado el acceso de gestión y de proveedores

    Las rutas administrativas merecen una validación más estricta que el tráfico ordinario de eventos. Confirme que la gestión de dispositivos esté limitada a servidores de salto aprobados, usuarios identificados y sesiones supervisadas. Compruebe si el acceso VPN de proveedores solo puede llegar a los sistemas contratados y si se desactiva fuera de las ventanas aprobadas.

    Compruebe si existen rutas alternativas a través de Wi-Fi, módems celulares, interfaces de red secundarias y portátiles de servicio. Un controlador aislado en la interfaz principal podría seguir exponiendo un servicio de gestión a través de un canal pasado por alto. El artículo de SectechMedia sobre refuerzo de la ciberseguridad del control de acceso aborda controles relacionados con dispositivos y credenciales.

    Incluir estados de fallo y recuperación

    La segmentación puede cambiar durante una conmutación por error. Pruebe cortafuegos redundantes, enlaces de respaldo, sitios de recuperación ante desastres y el enrutamiento temporal utilizado durante el mantenimiento. Confirme que un dispositivo de seguridad averiado no establezca de forma predeterminada una ruta sin restricciones y que las configuraciones restauradas conserven la política aprobada.

    Registre capturas de paquetes o pruebas de los registros para las pruebas críticas. Una simple hoja de trabajo de aprobado o suspenso es insuficiente cuando una regla cambia posteriormente o un equipo de incidentes necesita conocer la accesibilidad histórica.

    Gestionar las excepciones como riesgos con vencimiento

    Cada excepción debe identificar el responsable, el motivo, los controles compensatorios y la fecha de vencimiento. Vuelva a realizar pruebas después de actualizaciones de firmware, migraciones de VMS, sustituciones de controladores y rediseños de red. Haga seguimiento de rutas accesibles inesperadas, reglas obsoletas y activos fuera de su zona asignada. El resultado debe ser un programa de verificación vivo que detecte la deriva arquitectónica antes de que un atacante o una interrupción la ponga de manifiesto.

    Fuentes de referencia

  • Ciclo de vida de los certificados de dispositivos de seguridad y pruebas de caducidad

    Ciclo de vida de los certificados de dispositivos de seguridad y pruebas de caducidad

    Los certificados protegen cada vez más la comunicación entre cámaras, controladores de acceso, grabadores, servidores de gestión y clientes de operador. También pueden convertirse en un punto único de fallo oculto. Un certificado caducado puede bloquear el acceso de gestión, interrumpir la entrega de eventos o alentar a los operadores a omitir la validación durante una interrupción. Por tanto, la gestión del ciclo de vida debe probarse como un control operativo y no tratarse como un ejercicio anual con hojas de cálculo.

    Crear un inventario basado en la responsabilidad

    Registre el sujeto, emisor, número de serie, periodo de validez, uso de la clave, punto final, cadena de confianza y responsable de cada certificado. Incluya dispositivos integrados, proxies inversos, API, credenciales móviles y servicios internos. El inventario debe distinguir los certificados públicos de los certificados de infraestructura de clave pública privada y de los certificados autofirmados generados por los dispositivos.

    La responsabilidad importa porque la renovación puede involucrar a distintos equipos. Un integrador de seguridad puede gestionar las cámaras, la infraestructura corporativa puede operar la autoridad de certificación y un proveedor puede controlar un conector en la nube. Cada certificado necesita una ruta de decisión designada antes de caducar.

    Probar la validación desde los clientes reales

    Un certificado puede parecer correcto en una consola de gestión y, aun así, fallar en un grabador o controlador antiguo que no disponga de la cadena emisora. Realice pruebas desde cada clase de cliente, incluidos puestos de trabajo de operadores, aplicaciones móviles, API y servidores de conmutación por error. Valide la coincidencia del nombre de host, los anclajes de confianza, el comportamiento de revocación y la sincronización horaria. Las directrices de NIST para la gestión de claves subrayan que los controles criptográficos dependen de claves protegidas, ciclos de vida definidos y procesos con responsabilidades claras.

    No desactive la validación para conseguir que una prueba se complete. Si un cliente no puede admitir el modelo de confianza requerido, documente la limitación y aísle el riesgo mientras planifica su sustitución o una pasarela aprobada.

    Ensayar la renovación antes de la fecha límite

    Utilice un punto final que no sea de producción o un dispositivo piloto para ensayar las solicitudes de firma de certificados, la aprobación, la instalación y los requisitos de reinicio del servicio. Confirme si las claves privadas pueden permanecer en el dispositivo y si la renovación cambia las huellas digitales utilizadas por las integraciones. Pruebe periodos de validez superpuestos para poder distribuir una cadena nueva antes de que caduque la anterior.

    La supervisión automatizada debe advertir en varios umbrales, pero las alertas no son suficientes. Un ejercicio de renovación debe demostrar que el equipo puede obtener, desplegar y validar el reemplazo dentro de la ventana disponible. La guía de SectechMedia sobre inventario de activos y gestión de la configuración muestra cómo la responsabilidad y los registros de referencia respaldan este proceso.

    Proteger las claves y el material de recuperación

    Las claves privadas deben generarse y almacenarse según el riesgo y las capacidades del dispositivo. Restrinja la exportación, proteja las credenciales de inscripción y registre los cambios administrativos. Cuando no se disponga de almacenamiento respaldado por hardware, utilice controles compensatorios como el aislamiento de red, la gestión con privilegios mínimos y procedimientos rápidos de revocación.

    Realice copias de seguridad de la configuración de la autoridad de certificación y documente las dependencias de recuperación, pero evite copiar claves privadas en sistemas generales de incidencias o carpetas compartidas. Las pruebas de recuperación deben demostrar que los certificados pueden volver a emitirse sin reutilizar material de claves comprometido.

    Medir el estado del ciclo de vida

    Entre las métricas útiles se incluyen los certificados desconocidos, los certificados sin responsable, las rutas de validación fallidas, las renovaciones completadas antes del umbral y las excepciones de emergencia. Revise el inventario después de sustituir dispositivos, actualizar firmware y modificar la arquitectura. El objetivo no es simplemente que no haya caducidades; es mantener una confianza cifrada que sobreviva al mantenimiento rutinario y a la respuesta ante incidentes.

    Fuentes de referencia

  • Validación de actualizaciones de firmware de cámaras IP y planificación de la reversión

    Validación de actualizaciones de firmware de cámaras IP y planificación de la reversión

    Las actualizaciones de firmware son esenciales para la seguridad de las cámaras IP, pero una actualización también constituye un cambio controlado en un sistema activo de detección y pruebas. Una cámara que se reinicia correctamente puede volver con los análisis alterados, certificados perdidos, una hora incorrecta, un perfil de transmisión modificado o una integración con el VMS averiada. Por tanto, la gestión eficaz de las actualizaciones combina la urgencia de la ciberseguridad con pruebas de aceptación operativa.

    Comenzar con una línea base precisa de los activos

    Registre el modelo de la cámara, la revisión del hardware, el firmware actual, el cargador de arranque cuando esté expuesto, la exportación de la configuración, los certificados, los ajustes de transmisión, las reglas de análisis, la fuente horaria y la asociación con el VMS. Confirme que el paquete del fabricante se aplica a la variante exacta del dispositivo y lea todos los requisitos de versiones intermedias. Las directrices de NIST para la gestión empresarial de parches hacen hincapié en la planificación basada en el riesgo, el inventario y la verificación, en lugar de tratar las actualizaciones como un único evento técnico.

    La línea base debe incluir la calidad de imagen, la frecuencia de fotogramas, la tasa de bits, la generación de eventos y el comportamiento de grabación actuales. Para cámaras críticas, conserve clips y capturas de pantalla representativos para que el equipo pueda comparar el rendimiento después del cambio.

    Utilizar un grupo piloto representativo

    Seleccione cámaras que reflejen el parque desplegado sin situar en primer lugar el punto de cobertura de mayor riesgo. Incluya al menos un dispositivo que utilice cada patrón de integración importante, como análisis en el borde, E/S externa, transmisión cifrada o almacenamiento local. Aplique la actualización durante una ventana definida y mantenga sin cambios el resto del parque hasta que el grupo piloto complete el periodo de observación.

    Compruebe si el firmware restablece credenciales, desactiva protocolos, regenera certificados o modifica el comportamiento de seguridad predeterminado. Pueden ser mejoras intencionadas, pero deben incorporarse al plan de despliegue antes de ampliarlo.

    Validar la función, la seguridad y las pruebas

    Las pruebas de aceptación deben abarcar vídeo en directo y grabado, negociación de transmisiones, transiciones con poca luz, eventos de análisis, metadatos de alarmas, audio cuando esté autorizado, almacenamiento local, supervisión del estado y conmutación por error del VMS. Confirme la sincronización NTP y compare las marcas de tiempo entre la cámara, el grabador y el cliente del operador. Pruebe la autenticación con los roles previstos y verifique que los servicios obsoletos sigan desactivados.

    La supervisión de red debe confirmar los destinos y puertos esperados después de la actualización. Las conexiones salientes inesperadas, los cambios en el comportamiento DNS o los servicios de gestión en interfaces nuevas requieren investigación. La guía de refuerzo de redes de videovigilancia de SectechMedia ofrece un marco de control más amplio para esta revisión.

    Diseñar la reversión antes del despliegue

    La reversión puede consistir en una versión anterior compatible, la restauración de una exportación de configuración, la sustitución por un repuesto preparado o el servicio temporal desde una cámara adyacente. No suponga que el firmware puede volver a una versión anterior; verifique la compatibilidad del fabricante y las restricciones de firma. Defina las condiciones de parada que activan la reversión, el responsable de la decisión y la pérdida máxima de cobertura aceptable.

    Mantenga los paquetes, los hashes, las copias de seguridad de la configuración y las pruebas bajo control de cambios. Un registro de actualización completado debe identificar cada dispositivo, resultado, excepción y acción de seguimiento. Esto crea un vínculo auditable entre la corrección de vulnerabilidades y la continuidad de la cobertura de seguridad.

    Cerrar el cambio con pruebas supervisadas

    Después del despliegue, supervise durante un periodo definido los reinicios, las transmisiones interrumpidas, las lagunas de almacenamiento, las tasas de error de los análisis y las advertencias de certificados. Concilie el inventario final de firmware con el alcance aprobado. Actualice la documentación y los registros de vulnerabilidades únicamente después de que las pruebas operativas confirmen que el parque está actualizado y funciona correctamente.

    Fuentes de referencia